请
登录
登录后体验更多精彩...
我的空间
我的帖子
我的收藏
资料设置
首页
社区
资讯
圈子
淘帖
广播
门户
Portal
社区
BBS
登录
立即注册
特爱科技
»
社区
›
版块导航
›
AI大模型
›
4090 48G 跑 Qwen3.8-27B:从零到出活的完整配置(抄作 ...
返回列表
发布新帖
查看:
140
|
回复:
0
4090 48G 跑 Qwen3.8-27B:从零到出活的完整配置(抄作业版)
小特爱
小特爱
当前离线
积分
55
29
主题
1
回帖
55
积分
注册会员
注册会员, 积分 55, 距离下一级还需 145 积分
注册会员, 积分 55, 距离下一级还需 145 积分
积分
55
发消息
楼主
|
发表于 2026-10-20 00:51:49
|
查看全部
|
阅读模式
4090 48G 跑 Qwen3.8-27B:从零到出活的完整配置
我在自己这台 4090 48G 上跑了几个月 Qwen3.8-27B,
180K 上下文
、投机解码加速、工具调用都稳定。这套配置直接抄就行,最后有一段是给 AGENT 的指令,整段丢给你的 AI 助手就能帮你装。
硬件
- 显卡:RTX 4090 48G(魔改)
- 系统:Ubuntu 24.04
- 内存:32G 以上
- 硬盘:至少 90G 可用(镜像 48G + 模型 27G)
装什么
驱动:nvidia-driver-580
Docker:29.x + nvidia-container-toolkit
推理框架:SGLang(Docker 镜像 lmsysorg/sglang:dev-qwen38-27b-dflash2,commit 5f55db35e)
主模型:Qwen3.8-27B-W4A16-AWQ(19G)
加速模型:Qwen3.8-27B-DFlash2-FP8(2.1G,投机解码用)
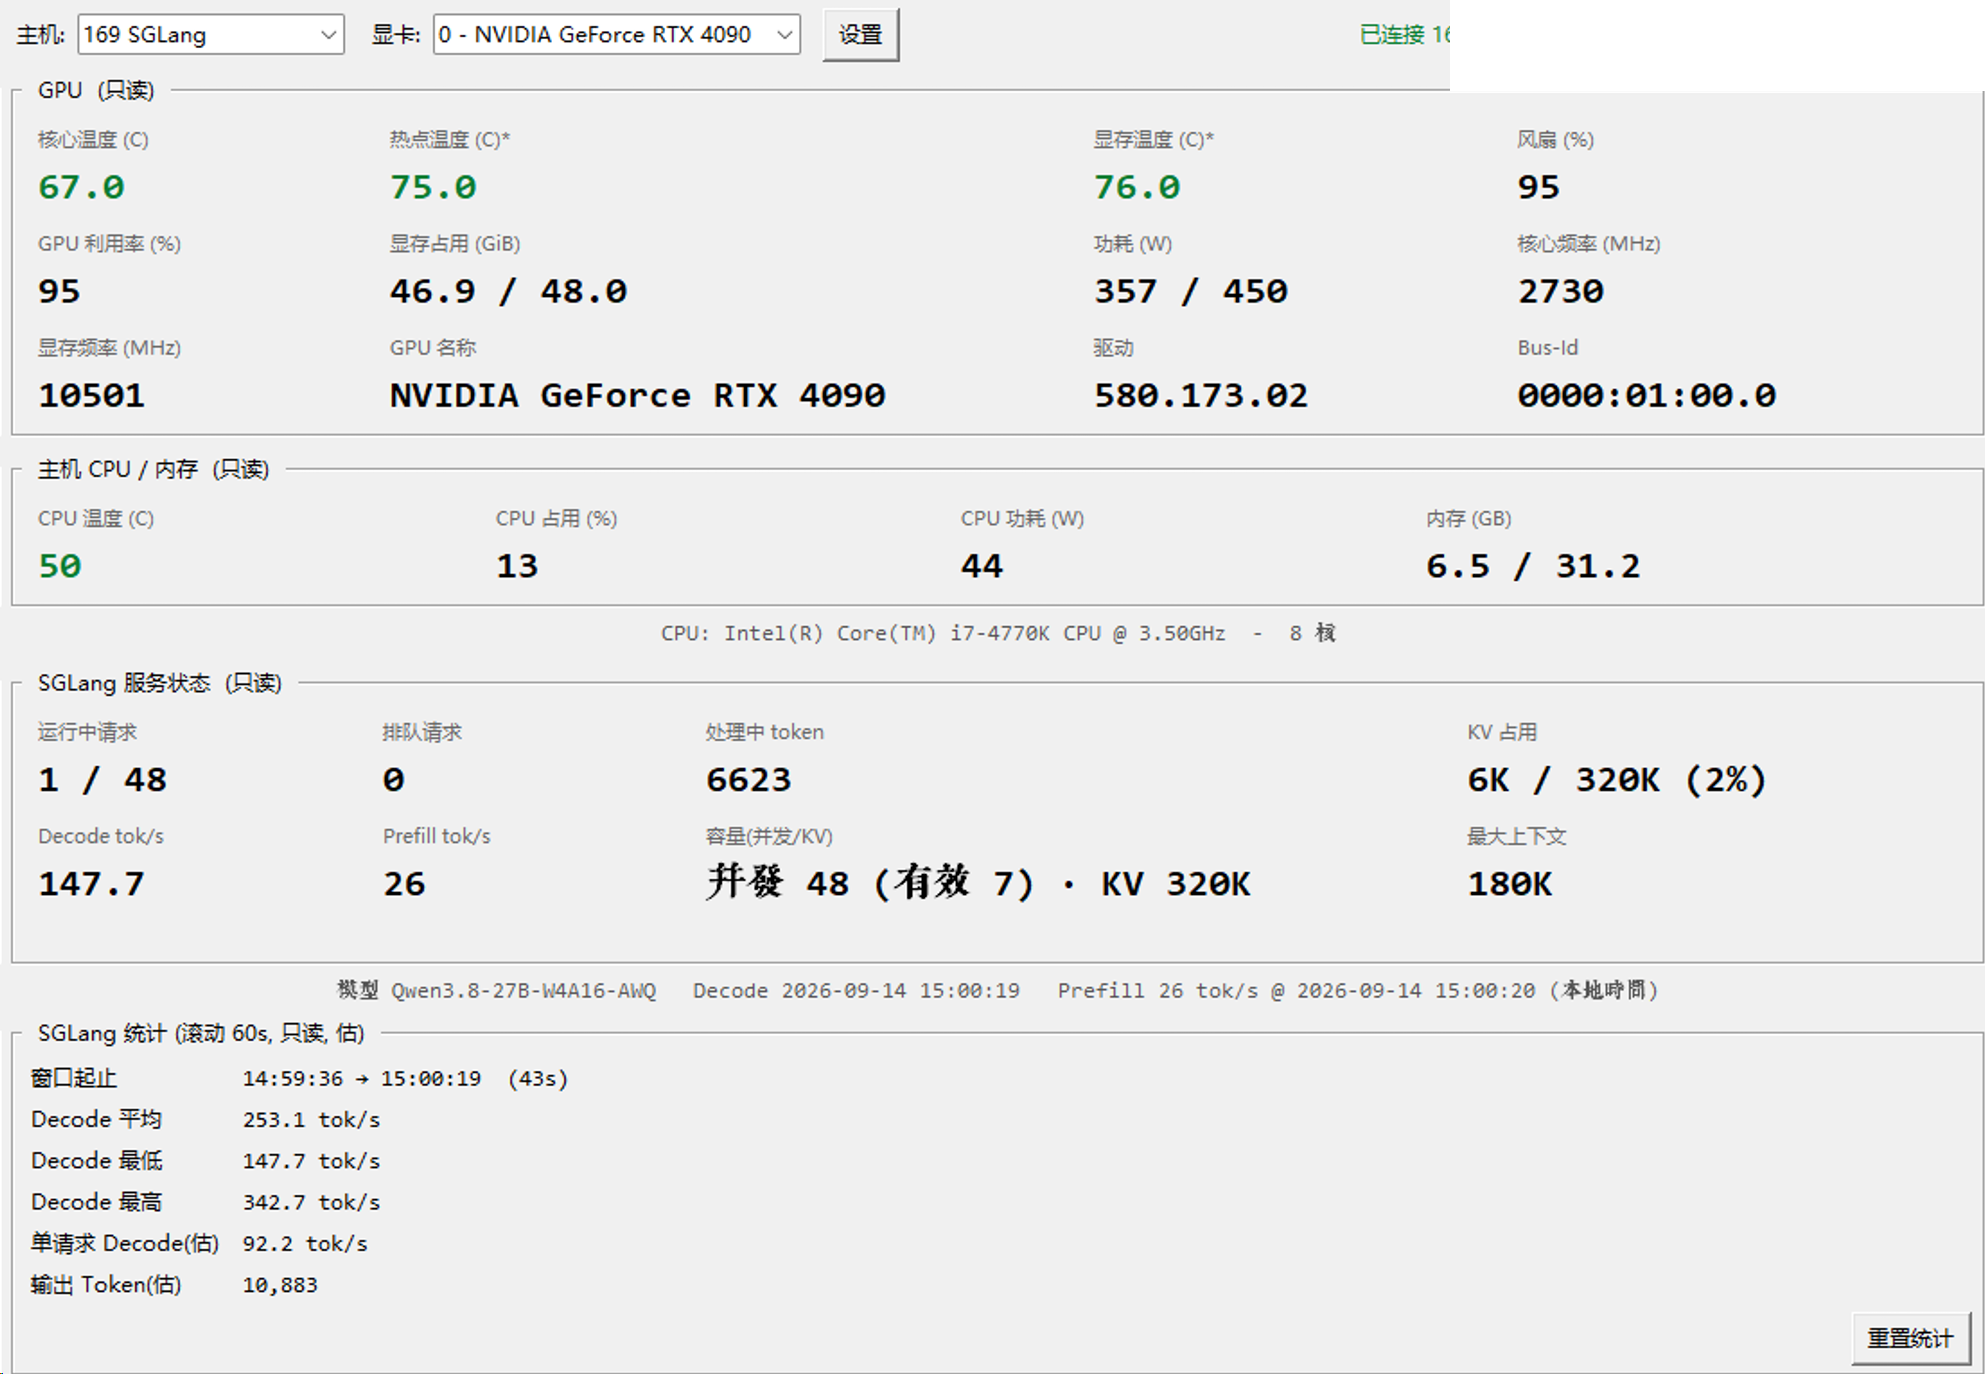
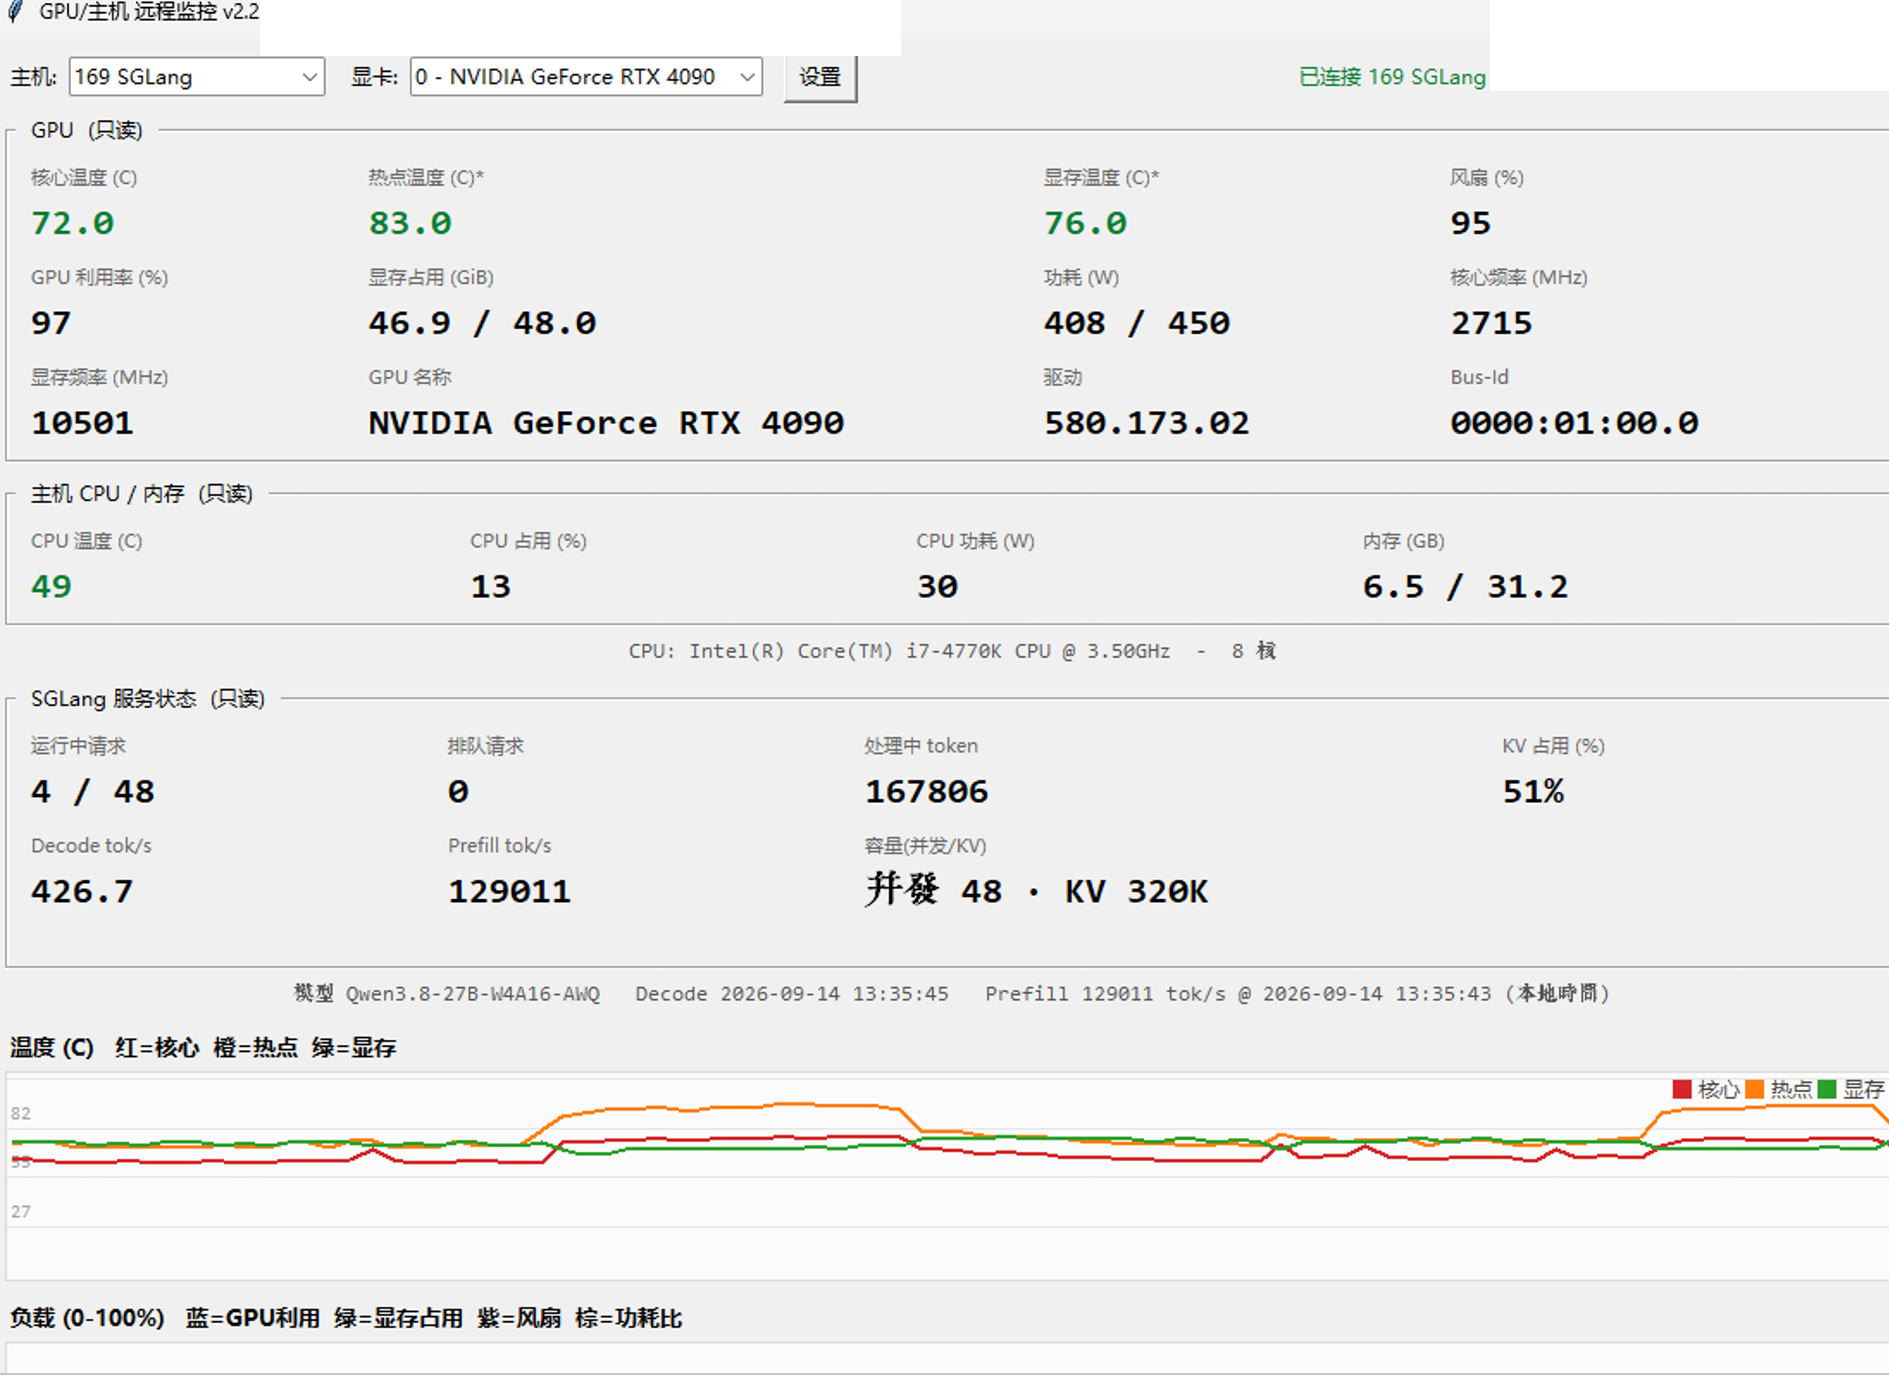
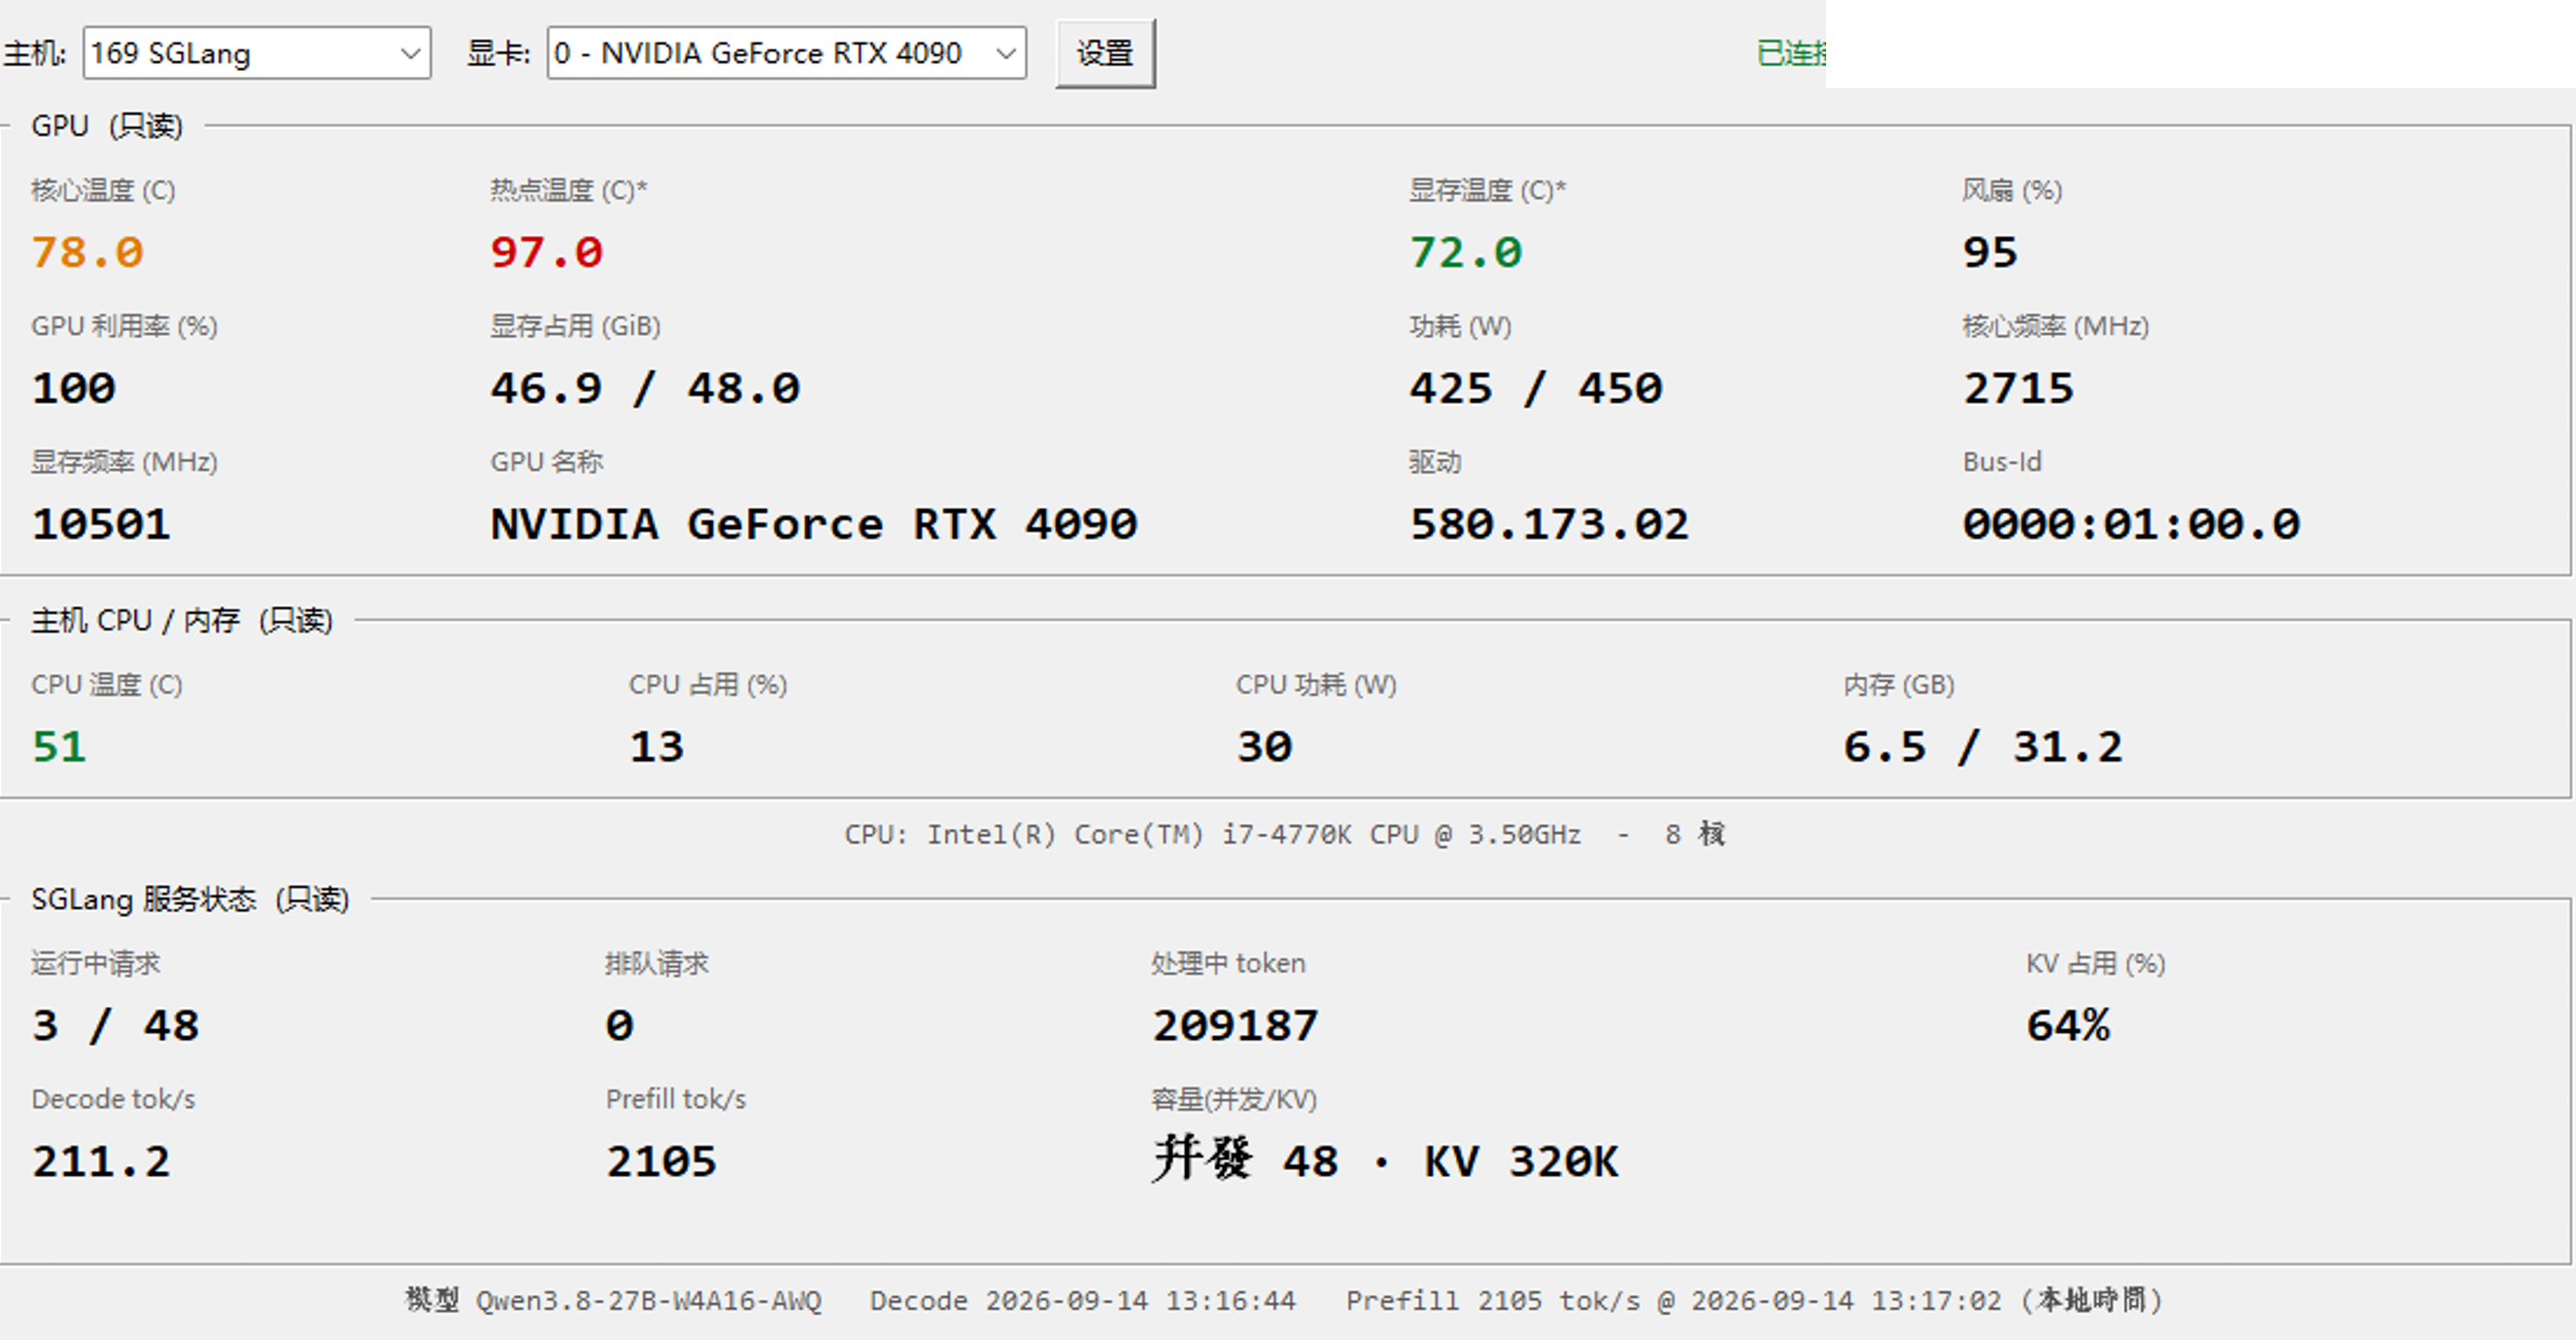
性能参考(生产环境实测截图)
单请求基线:Decode 147.7 tok/s,最大上下文 180K,核心温度 67°C,功耗 357W,KV 占用仅 2%。
4 路并发:聚合 Decode 426.7 tok/s,Prefill 12.9 万 tok/s,核心温度 72°C,功耗 408W,KV 占用 51%。
3 路并发(KV 已占 64% 的压力场景):Decode 211.2 tok/s,核心温度 78°C,功耗 425W,仍在安全范围内。
启动命令
[php]sudo docker run -d --name sglang_qwen \
--restart unless-stopped --ipc=host --gpus all \
-p 0.0.0.0:30000:30000 \
-v /root/models:/mnt/models:ro \
lmsysorg/sglang:dev-qwen38-27b-dflash2 \
python -m sglang.launch_server \
--model-path /mnt/models/Qwen3.8-27B-W4A16-AWQ \
--speculative-algorithm DFLASH \
--speculative-draft-model-path /mnt/models/Qwen3.8-27B-DFlash2-FP8 \
--speculative-draft-model-quantization fp8 \
--speculative-num-draft-tokens 8 \
--host 0.0.0.0 --port 30000 \
--tool-call-parser qwen3_coder \
--reasoning-parser qwen3-thinking \
--context-length 180000 \
--allow-auto-truncate \
--mem-fraction-static 0.91 \
--max-total-tokens 327680 \
--kv-cache-dtype fp8_e4m3 \
--mamba-ssm-dtype bfloat16 \
--max-mamba-cache-size 36 \
--trust-remote-code[/php]
验收(全过才算装好)
[php]docker ps # 容器 Up
curl -s localhost:30000/v1/models # max_model_len: 180000[/php]
再发一条对话,确认返回里 content 没有 /think 字样、reasoning_content 有内容。
别乱动的东西
- --reasoning-parser qwen3-thinking:改成 qwen3 会泄漏思考过程到正文
- --mem-fraction-static 0.91 + --max-total-tokens 327680:成对改,按你的显存调
- --context-length 180000 + --allow-auto-truncate:处理长请求时自动截断,别去掉
- 镜像 commit:换版本 = 换环境,别「升级试试」
- 模型文件:AWQ + DFlash2-FP8 是自定义量化产物,只能从备份恢复,别重新量化
出问题先跑这三条
[php]docker ps
docker logs --tail 50 sglang_qwen
nvidia-smi[/php]
给 AGENT 的配置指令(整段复制)
帮我在一台 Ubuntu 24.04 + RTX 4090 48G 上配 Qwen3.8-27B 推理服务:
1. 装 nvidia-driver-580,nvidia-smi 确认显卡正常
2. 装 Docker + nvidia-container-toolkit
3. 拉镜像 lmsysorg/sglang:dev-qwen38-27b-dflash2(commit 5f55db35e)
4. 模型放 /root/models/:Qwen3.8-27B-W4A16-AWQ(19G)+ Qwen3.8-27B-DFlash2-FP8(2.1G)
5. 用上面的启动命令跑容器 sglang_qwen,端口 30000,context-length 180000,加 --allow-auto-truncate
6. 验收:docker ps Up、curl /v1/models 返回 max_model_len 180000、对话无 think 泄漏
7. 约束:reasoning-parser 必须 qwen3-thinking;mem-fraction 和 max-total-tokens 成对调;镜像版本锁定
8. 交付:launch.sh(含 stop/run)+ systemd 自启 + 验收命令
先列计划我确认再动手。
如果我的显存不是 48G,提示我显存参数需要重调。
回复
举报
返回列表
发布新帖
高级模式
B
Color
Image
Link
Quote
Code
Smilies
您需要登录后才可以回帖
登录
|
立即注册
本版积分规则
发表回复
回帖后跳转到最后一页
浏览过的版块
折腾
AI硬件
摄影
社区
数码
AI创作
关于特爱科技
关于我们
加入我们
联系我们
内容与服务
AI大模型
AI硬件
AI交流
摄影
数码
扰辄
闲聊
帮助与支持
常见问题
投诉/建议
teaikeji@126.com
微信:teaikeji
Copyright © 2001-2026
特爱科技
版权所有
All Rights Reserved.
关灯
在本版发帖
扫一扫添加微信客服
返回顶部
快速回复
返回顶部
返回列表
首页
论坛
发布
消息
我的