请
登录
登录后体验更多精彩...
我的空间
我的帖子
我的收藏
资料设置
首页
社区
资讯
圈子
淘帖
广播
门户
Portal
社区
BBS
登录
立即注册
特爱科技
»
社区
›
版块导航
›
折腾
›
128GB 内存的电脑本地跑通 Qwen3.8 27B,全流程就一条命 ...
返回列表
发布新帖
查看:
152
|
回复:
0
128GB 内存的电脑本地跑通 Qwen3.8 27B,全流程就一条命令
小特爱
小特爱
当前离线
积分
55
29
主题
1
回帖
55
积分
注册会员
注册会员, 积分 55, 距离下一级还需 145 积分
注册会员, 积分 55, 距离下一级还需 145 积分
积分
55
发消息
发表于 2026-10-1 17:52:29
|
查看全部
|
阅读模式
前几天终于把一台 Linux 机器折腾利索了:Ubuntu 24.04、AMD Ryzen AI MAX+ 395、Radeon 8060S 核显、128GB 统一内存。这套配置天然就是为本地大模型准备的。
之前跑了一段时间 Qwen3.7 27B 的未审查版,体验了一把"无删减"的快乐。这次 Qwen3.8 27B 一发布,我就把整个部署流程从头到尾重新跑了一遍,完整记录下来。
01 为什么要把模型部署到本地
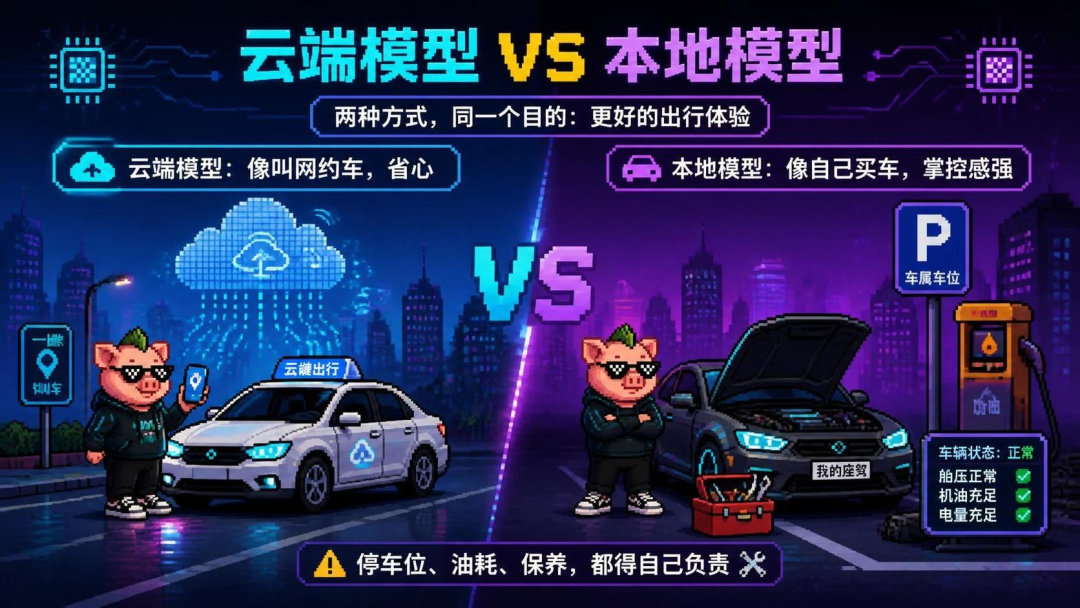
理由都很实际:
- 隐私:私人资料留在自己电脑里,不用先传到云端
- 离线:模型下载完成后,断网也能继续用
- 不限次:没有网页会员的次数限制,想怎么测就怎么测
- 可集成:本地 API 能接进脚本、知识库和其他 AI 工具
- 知边界:亲手跑一遍,才知道自己电脑的能力上限
最终效果:一条命令,Windows 或 Linux 电脑就能跑起 Qwen3.8 27B。模型下载约 13GB,断网也能聊。
02 先搞懂几个名词
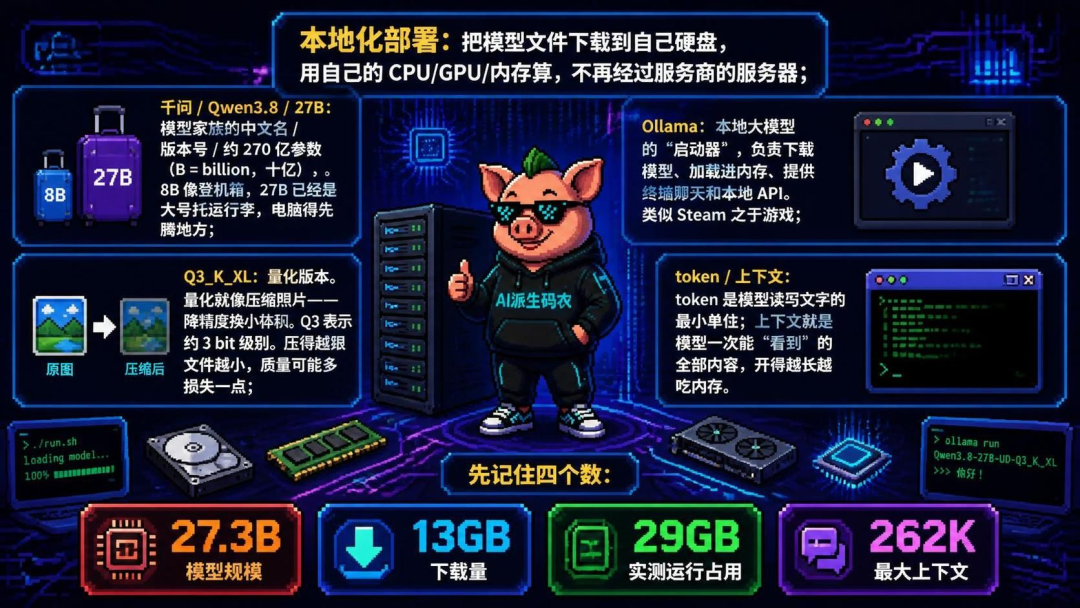
第一次接触本地大模型,最容易被一串名字劝退。先翻译成人话——
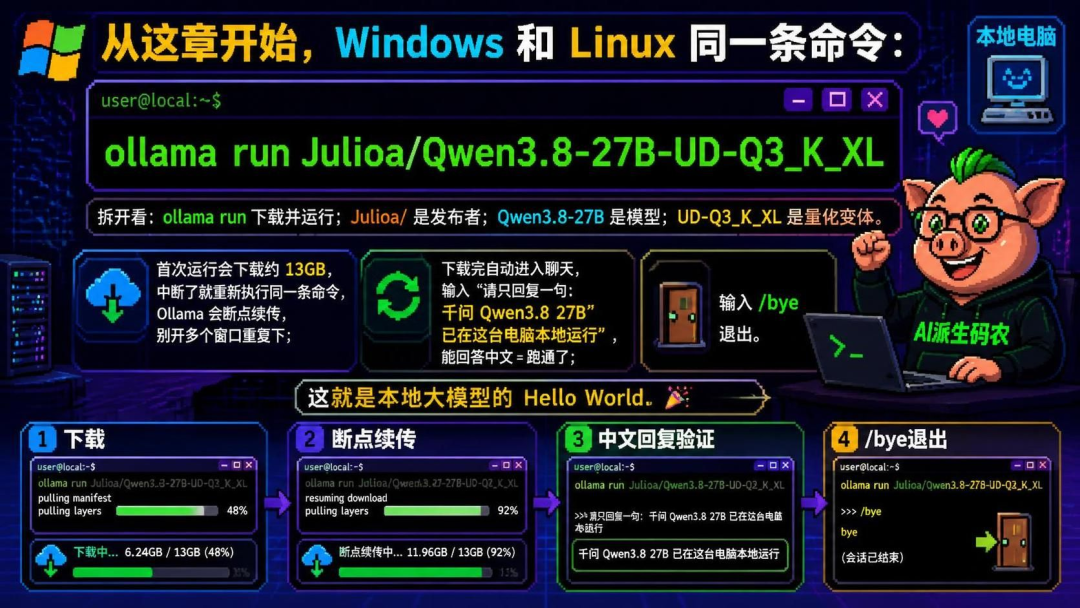
核心命令的含义就是:让 Ollama 去下载 Julioa 发布的 Qwen3.8 27B 压缩模型,然后在这台电脑上启动它。
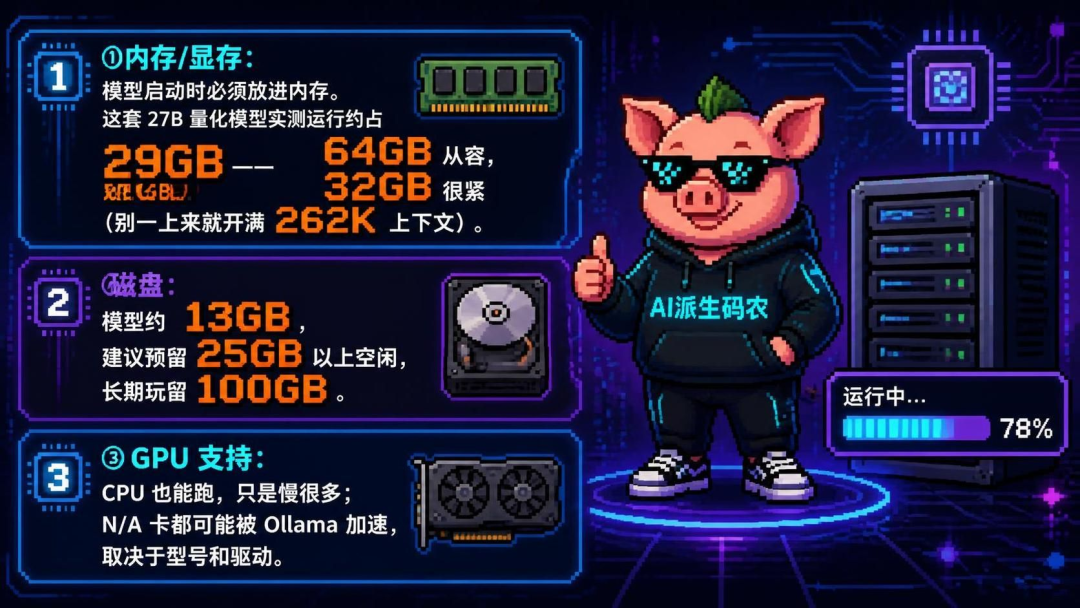
03 动手前花 2 分钟检查电脑
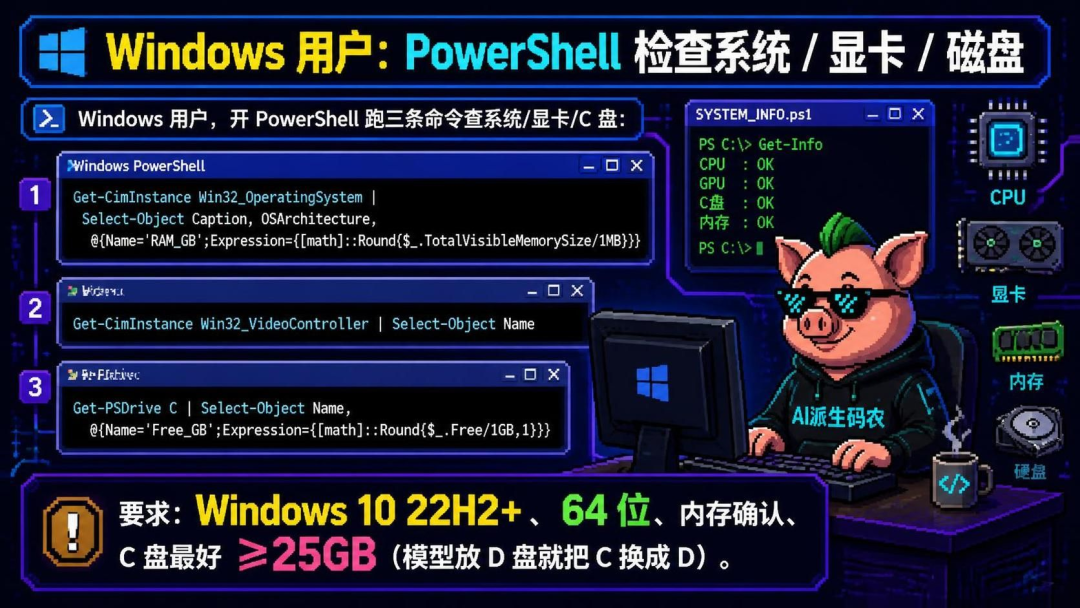
模型下到 90% 才发现磁盘不够,最浪费时间。先看三个硬指标:
Windows 用户,开 PowerShell 跑三条命令查系统/显卡/C 盘:
Get-CimInstance Win32_OperatingSystem | Select-Object Caption, OSArchitecture, @{Name='RAM_GB';Expression={[math]::Round($_.TotalVisibleMemorySize/1MB)}}
Get-CimInstance Win32_VideoController | Select-Object Name
Get-PSDrive C | Select-Object Name, @{Name='Free_GB';Expression={[math]::Round($_.Free/1GB,1)}}
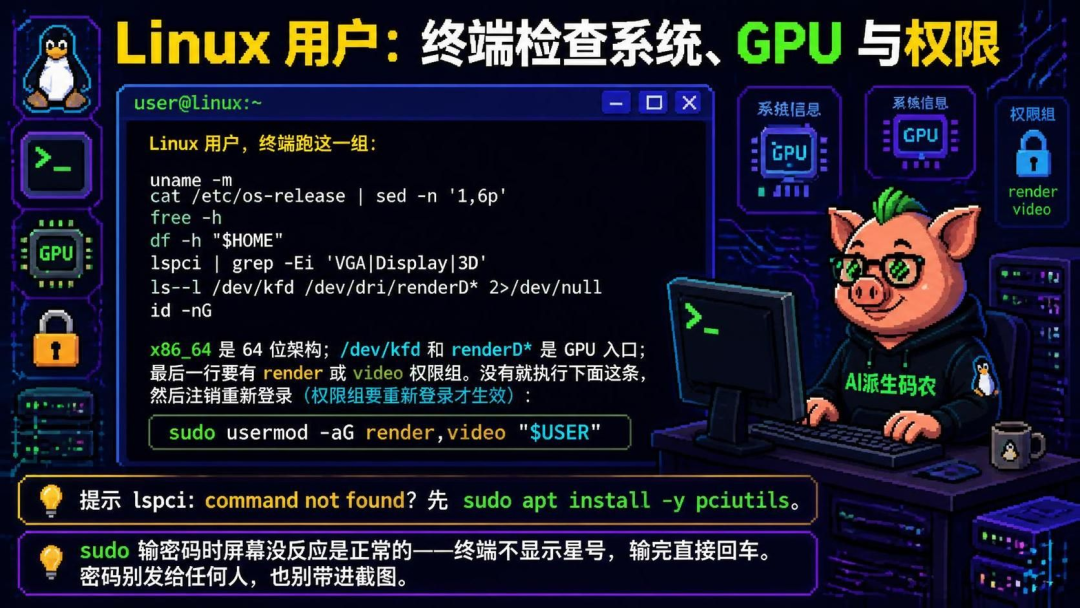
Linux 用户:
uname -m
cat /etc/os-release | sed -n '1,6p'
free -h
df -h "$HOME"
lspci | grep -Ei 'VGA|Display|3D'
ls -l /dev/kfd /dev/dri/renderD* 2>/dev/null
id -nG
x86_64 是 64 位架构;/dev/kfd 和 renderD* 是 GPU 入口;最后一行要有 render 或 video 权限组。没有就执行下面这条,然后注销重新登录(权限组要重新登录才生效)。
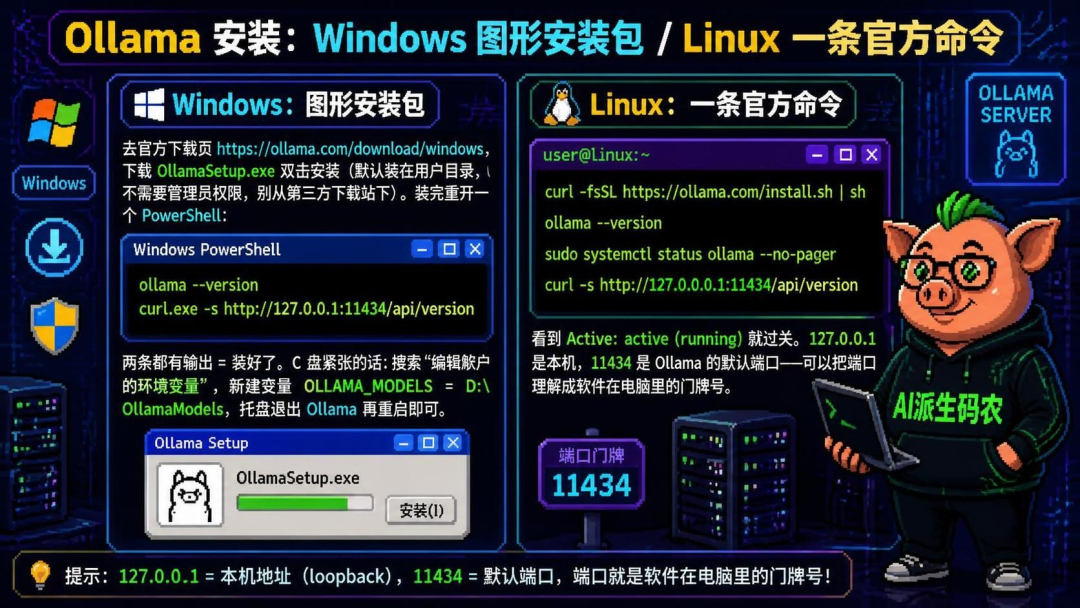
04 安装 Ollama(模型启动器)
05 一条命令跑通第一次对话
ollama run Julioa/Qwen3.8-27B-UD-Q3_K_XL
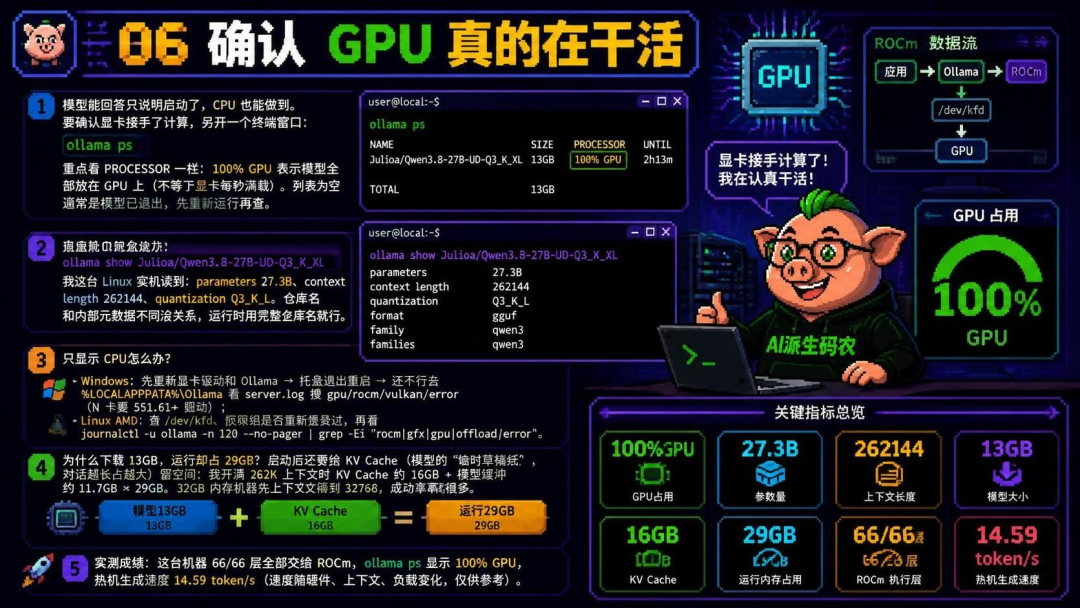
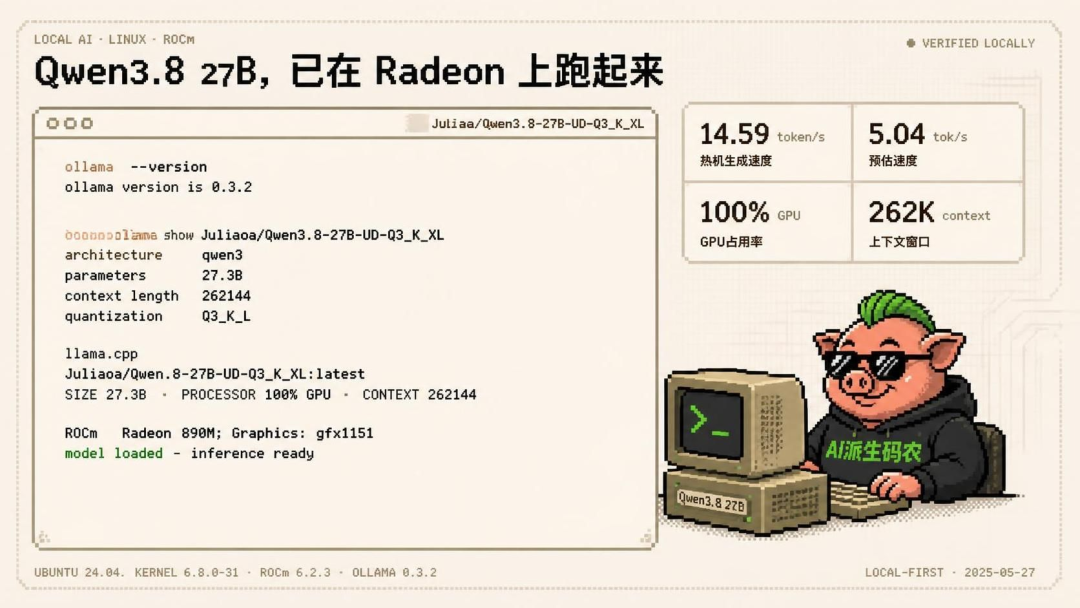
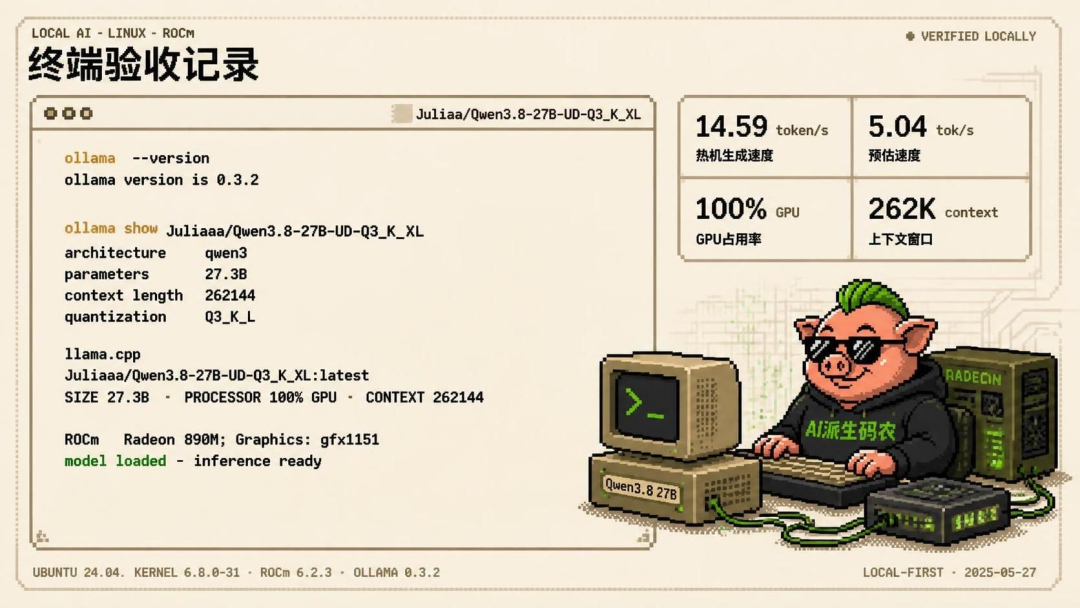
06 确认 GPU 真的在干活
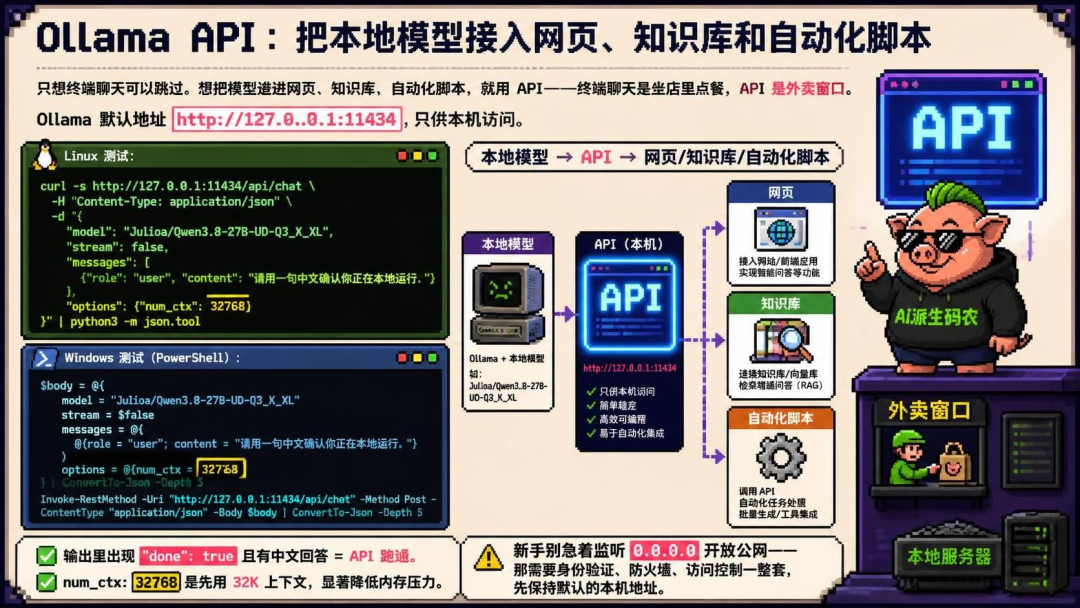
07 让网页和其他软件调用它(API)
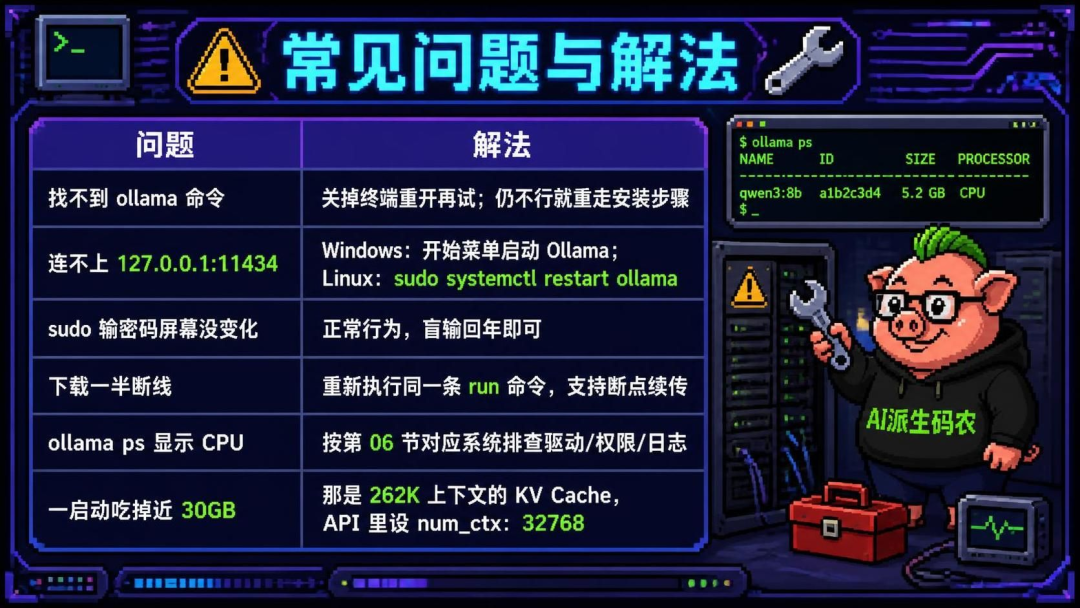
08 六个最常见的问题
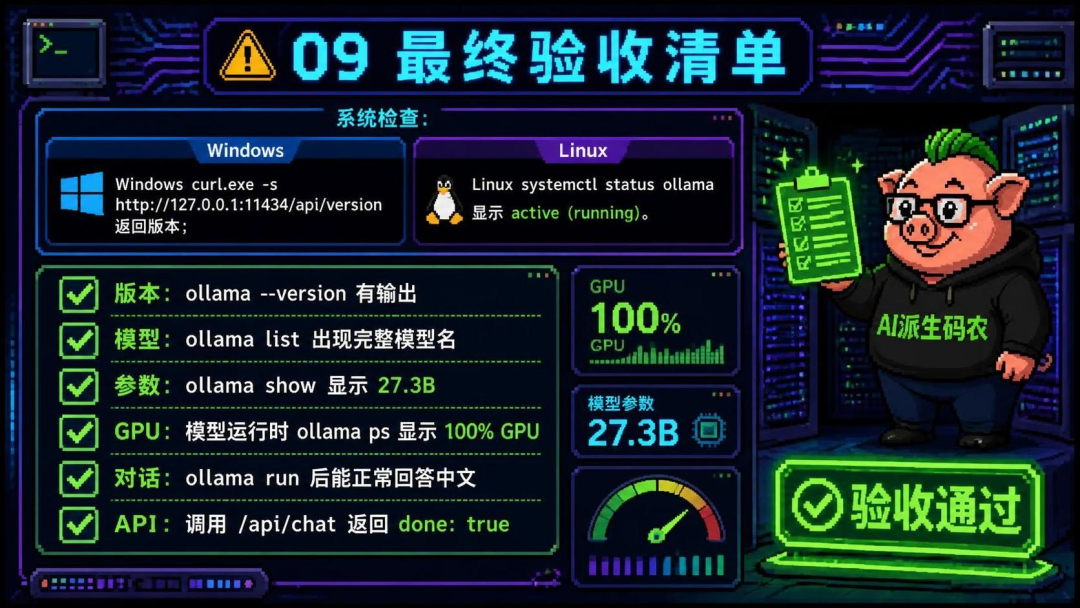
09 最终验收清单
系统检查:Windows 用 `curl.exe -s http://127.0.0.1:11434/api/version` 返回版本;Linux 用 `systemctl status ollama` 显示 active (running)。
然后六项通用验收:
- 版本:`ollama --version` 有输出
- 模型:`ollama list` 出现完整模型名
- 参数:`ollama show` 显示 27.3B
- GPU:模型运行时 `ollama ps` 显示 100% GPU
- 对话:`ollama run` 后能正常回答中文
- API:调用 /api/chat 返回 done: true
回复
举报
返回列表
发布新帖
高级模式
B
Color
Image
Link
Quote
Code
Smilies
您需要登录后才可以回帖
登录
|
立即注册
本版积分规则
发表回复
回帖后跳转到最后一页
浏览过的版块
AI硬件
摄影
AI大模型
数码
社区
关于特爱科技
关于我们
加入我们
联系我们
内容与服务
AI大模型
AI硬件
AI交流
摄影
数码
扰辄
闲聊
帮助与支持
常见问题
投诉/建议
teaikeji@126.com
微信:teaikeji
Copyright © 2001-2026
特爱科技
版权所有
All Rights Reserved.
关灯
在本版发帖
扫一扫添加微信客服
返回顶部
快速回复
返回顶部
返回列表
首页
论坛
发布
消息
我的



 发表于 2026-10-1 17:52:29