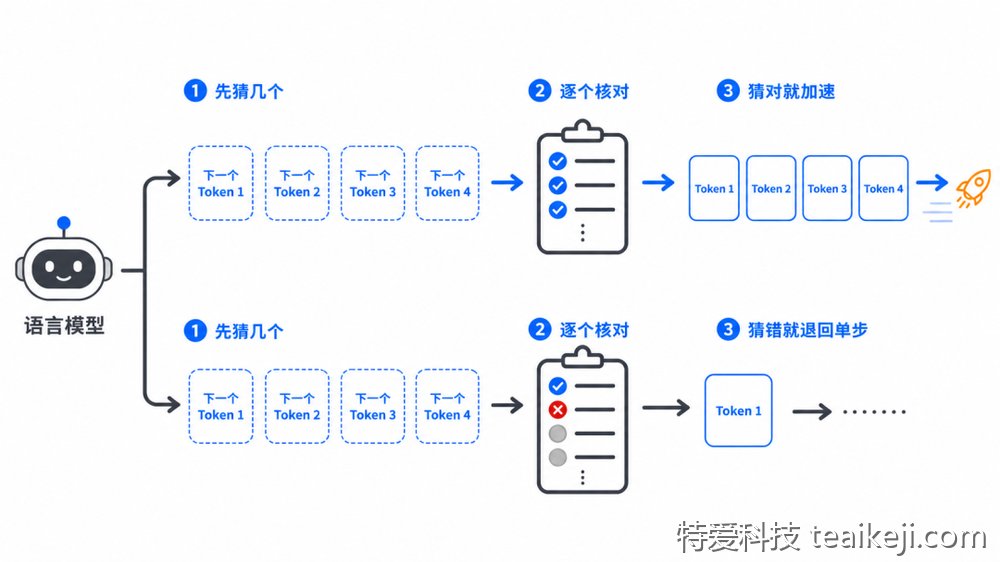
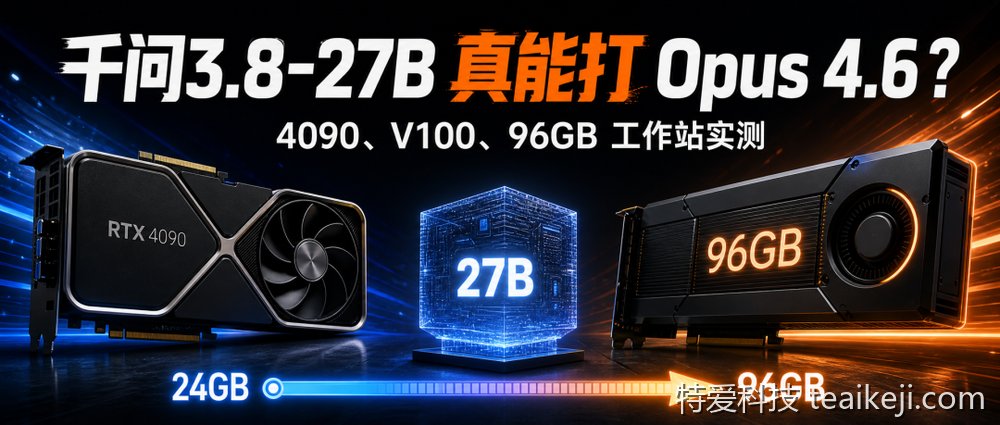
真正落地,速度是绕不过去的坎。我用96GB统一内存的M2 Max跑,生成速度只有5 Token/s,能回答、能写代码,但任务一长,等待就让人没耐心。社区里,M4 Max 128GB跑oQ4并打开MTP,大约13 Token/s;24GB Mac Mini M4上只有2到4 Token/s。数字差距很大,通常来自量化版本、推理后端、上下文长度和MTP开关。Mac内存不同,体验也可以完全两样。我又拿一台约4000元的双V100机器,2×16GB合计32GB显存,做对比。两张卡各自分配显存,模型切分和卡间通信都会占空间:短上下文时约25 Token/s,上下文拉长后掉到12 Token/s。用Q4量化对比千问3.6-27B,3.8预填充速度下降约40%,生成速度下降约20%。长文本尤其明显,前几千字还正常,内容一多,机器就开始拖,风扇往往比人先热。
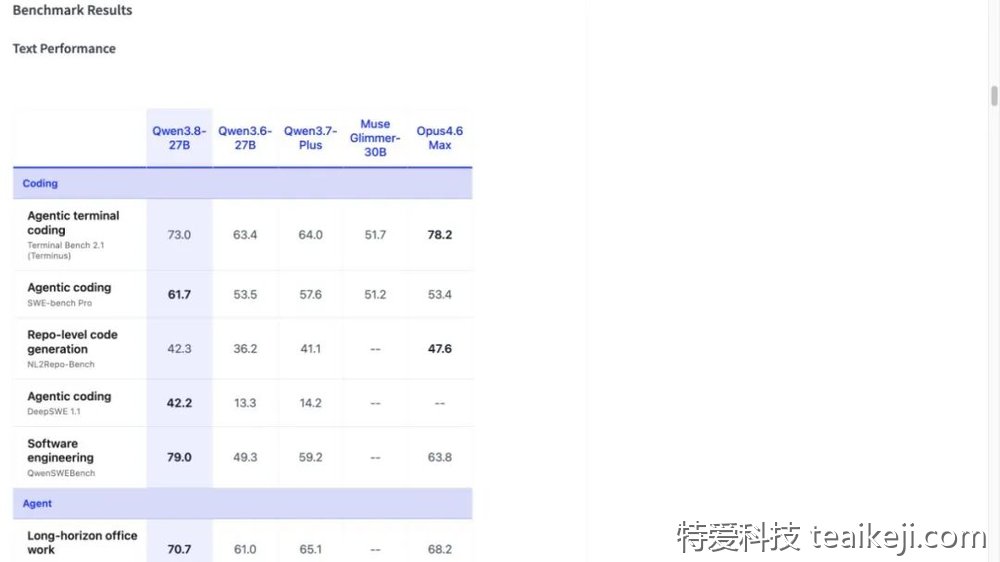
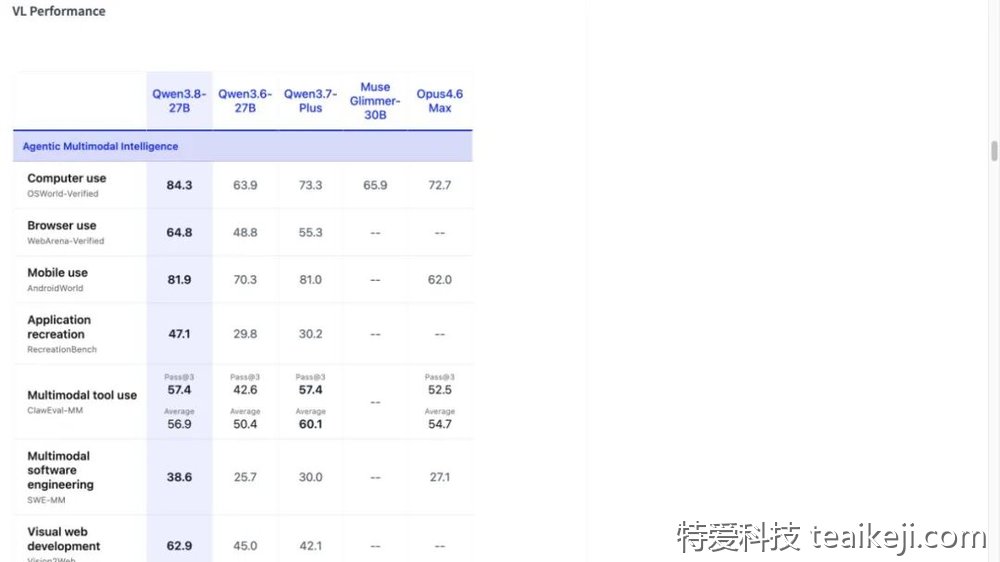
我用RTX PRO 6000 96GB跑BF16原版权重,打开全精度KV、视觉和原生MTP,复杂任务完成度很高,尤其全栈应用部分,已经不像传统意义上的本地小模型。在之前同一套测试里,它超过GPT-5.5,贴近GPT-5.6,只在少数项目还差一点。可十几万元的卡,生成速度没有和价格一起飞上天:预填充很快,单路生成却没想象中夸张。我用的是vLLM,它更偏多并发吞吐,单人单路聊天未必是最优场景。高端卡有时给的是同时处理更多任务的能力,不一定是一个人聊天时每秒多吐几十个Token。