请
登录
登录后体验更多精彩...
我的空间
我的帖子
我的收藏
资料设置
首页
社区
资讯
圈子
淘帖
广播
门户
Portal
社区
BBS
登录
立即注册
特爱科技
»
社区
›
版块导航
›
折腾
›
双3090 AI工作流:从自动配图、视频到无人值守发文的实 ...
返回列表
发布新帖
查看:
134
|
回复:
0
双3090 AI工作流:从自动配图、视频到无人值守发文的实战链路
小特爱
小特爱
当前离线
积分
55
29
主题
1
回帖
55
积分
注册会员
注册会员, 积分 55, 距离下一级还需 145 积分
注册会员, 积分 55, 距离下一级还需 145 积分
积分
55
发消息
楼主
|
发表于 2026-10-2 18:26:23
|
查看全部
|
阅读模式
夜里两点,我合上电脑去休息,机器却继续工作:查资料、写稿、生成插图、检查画面、排版,等天亮时,一篇带图的公众号稿子已经停在草稿箱,只差发布。这套流程不是演示,而是我日常依赖的双3090自动化链路。前面讲过Q4加256K上下文为什么合适,这里直接落到具体任务上。
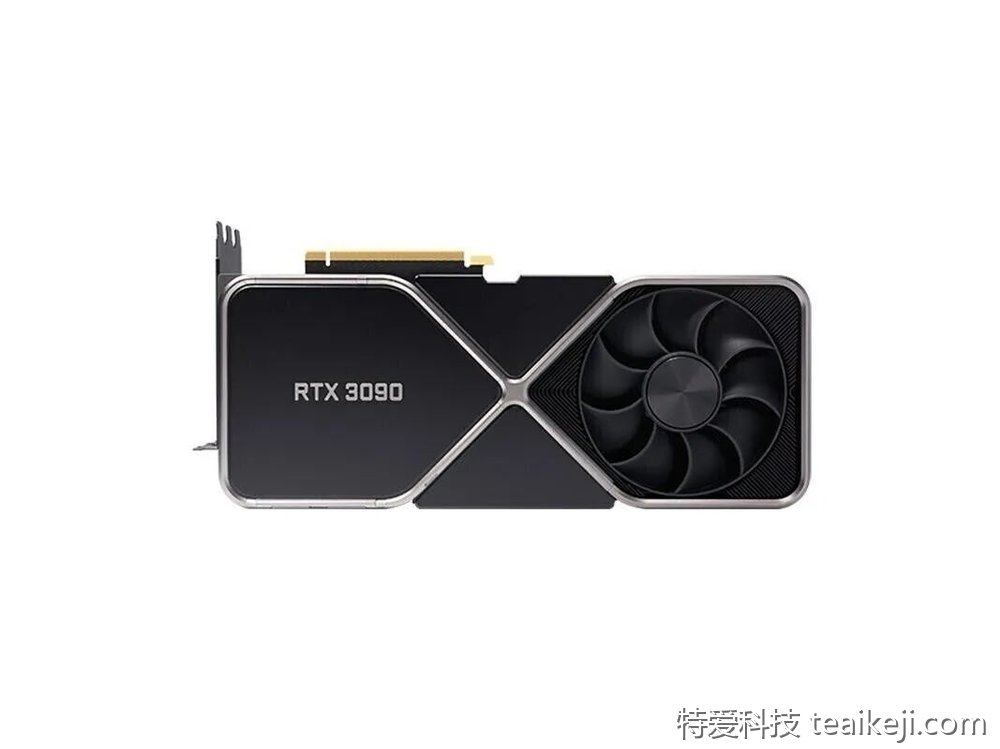
这套链路的核心分工很简单:GPU 0当大脑,运行Qwen3.8-27B,负责思考、判断和决策;GPU 1当手脚,运行ComfyUI、视频模型或搜索服务,负责执行。两块显卡物理隔离、显存独立,才能真正做到并行。因为Qwen3.8-27B原生支持多模态,大脑能看图、看视频,可以自己审查、自己纠错,所以整条流程不需要人一直盯着,可以24小时运行。
这套架构能成立,前提是Q4量化。Q4让模型只占一张卡,大约17GB,另一张卡完全空出来干活。它不是降低体验的妥协,而是让双卡分工成立的基础。如果用Q8,约37GB会把两张卡吃满,前面那些并行场景基本都跑不了。
先看最直接的自主生图。我只给一句需求,比如写AI绘画发展史并配三张插图,后续都由智能体安排。GPU 0上的智能体先检索资料,把关键信息放进256K上下文,边写正文边标出插图位置。每个插图位置都会生成一段精确的英文提示词,再调用GPU 1上的ComfyUI接口出图。图片在渲染时,它继续写后文,不用干等。图出来后,它自己检查构图、风格是否统一、是否贴合段落,不合格就改提示词重新生成,合格才插入正文。
这条链路依赖几个现成组件:ComfyUI_Skills_OpenClaw在GitHub上有403星,给智能体提供控制ComfyUI的命令行入口;Comfy官方MCP协议负责标准化接口调用;Hermes本身带ComfyUI技能,可以直接通过REST/WebSocket下发任务。
视频生成更复杂,但思路一致:智能体先写脚本和分镜,再调用GPU 1上的视频模型。2026年8月,有两个新选项值得注意。Lightricks在8月发布的LTX-2.5是22B参数的双流diffusion transformer,被称为全球最快视频生成模型,原生支持4K/50fps,并带同步音频,适合批量生成片段后挑选拼接。MiniMax H3在8月3日开源权重,是33B参数的omni-modal模型,视频和原生立体声音频在同一个transformer里联合生成,最高2K/15秒,更偏成品级输出。两者都能在3090 24GB上运行,并且原生支持ComfyUI。智能体会根据任务自动选择:赶速度用LTX-2.5,要质量用MiniMax H3。
视频也有审查闭环。生成完成后,它抽取几帧检查画面质量和内容匹配度,不满意就调整参数重来。以30秒产品宣传片为例,它会把片子拆成6个5秒分镜,逐个用LTX-2.5生成并抽帧检查;全部通过后,再交给MiniMax H3升级成带音频的高质量成片,最后自动拼接导出。
我每天都在跑的另一条链路,是全自动写文、配图、发布。Hermes智能体在GPU 0上调用Qwen3.8-27B写文章,GPU 1同时运行ComfyUI出图和本地RAG服务,其中搜索用SearXNG,再配合网页提取。三个服务分开占用显存,不会互相干扰。
流程是:先搜索最新资料,再由Qwen3.8-27B成文,然后自动调用ComfyUI生成配图;智能体检查图片,不合格就重做,合格后再调用发布接口,把内容推送到公众号和头条。
这里最关键的,是Qwen3.8-27B的多模态审查能力。如果只用纯文本模型,图出来后它看不见,必须人工检查;而它能自己看图、判断质量、发现问题并纠正。所谓无人值守,真正靠的是模型能力,不是话术。
这条链路扩展空间也不小:把搜索源换成Obsidian知识库,把发布平台换成头条、CSDN或百家号,把主题换成AI教程,就能组成一条完整的自媒体自动化流水线。
还有一张卡干活、一张卡待命的用法。日常把一个小模型常驻在GPU 1,负责即时问答,响应快,不用每次等大模型加载;GPU 0则留给大模型推理、批量出图、视频渲染这类重任务。这样跑大任务时,日常服务不会被拖垮,两张卡各干各的。
这是双卡最朴素的分工,但前面那几条自动化链路才是双3090真正的杀手锏。
如果你已经有一张3090,相当于先有了大脑;再补一张9000多元的二手3090,就有了手脚。Q4量化把大脑限制在一张卡内,另一张卡就能专注执行。
我的实际配置是:i5-12490F + 32GB DDR5-6000 + 双RTX 3090(48GB)+ Ollama 0.34.0;Qwen3.8-27B Q4单卡约17GB,256K上下文加q4 KV约25GB。ComfyUI固定在GPU 1,Hermes负责编排,整条链路全自动运行。
前面那篇说明文已经发过,搜索“双3090 Qwen3.8 为什么Q4够了”就能找到,里面讲了选型逻辑和架构原理。如果这些实战内容对你有帮助,可以点个关注,后续会继续分享双3090的更多用法;点赞、在看、转发,也是我持续更新的动力。
回复
举报
返回列表
发布新帖
高级模式
B
Color
Image
Link
Quote
Code
Smilies
您需要登录后才可以回帖
登录
|
立即注册
本版积分规则
发表回复
回帖后跳转到最后一页
浏览过的版块
摄影
AI硬件
AI大模型
数码
社区
关于特爱科技
关于我们
加入我们
联系我们
内容与服务
AI大模型
AI硬件
AI交流
摄影
数码
扰辄
闲聊
帮助与支持
常见问题
投诉/建议
teaikeji@126.com
微信:teaikeji
Copyright © 2001-2026
特爱科技
版权所有
All Rights Reserved.
关灯
在本版发帖
扫一扫添加微信客服
返回顶部
快速回复
返回顶部
返回列表
首页
论坛
发布
消息
我的