请
登录
登录后体验更多精彩...
我的空间
我的帖子
我的收藏
资料设置
首页
社区
资讯
圈子
淘帖
广播
门户
Portal
社区
BBS
登录
立即注册
特爱科技
»
社区
›
版块导航
›
AI硬件
›
RTX 4090 解锁 Tensor Core 算力接近翻倍,二手 3090 Ti ...
返回列表
发布新帖
查看:
95
|
回复:
0
RTX 4090 解锁 Tensor Core 算力接近翻倍,二手 3090 Ti 价格已超 2600 美元
小特爱
小特爱
当前离线
积分
55
29
主题
1
回帖
55
积分
注册会员
注册会员, 积分 55, 距离下一级还需 145 积分
注册会员, 积分 55, 距离下一级还需 145 积分
积分
55
发消息
发表于 2026-10-26 15:33:45
|
查看全部
|
阅读模式
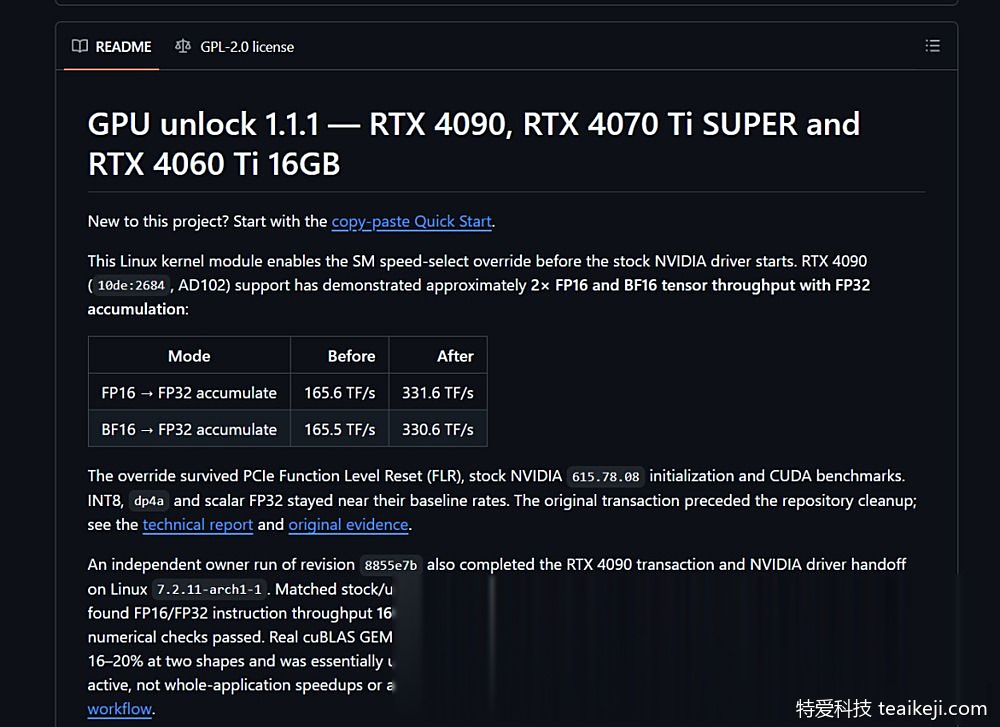
继前文介绍 RTX 30 系列通过开源方案解锁隐藏 AI 算力之后,社区开发者把同一思路扩展到了 Ada Lovelace 架构。GitHub 项目 gpu-unlock-ada 针对 RTX 4090 的 AD102 芯片,通过 Linux 内核模块在英伟达官方驱动加载之前修改 GPU 速度选择参数,解除部分 Tensor Core 运算限制。
整个过程不需要刷写修改版显卡 BIOS,也不需要替换或破解官方驱动。
项目地址:github.com/JustAResearcher/gpu-unlock-ada
根据项目公布的数据,RTX 4090 在 FP16 累加 FP32 测试中的吞吐量从 165.6 TFLOPS 提升至 331.6 TFLOPS,BF16 则从 165.5 TFLOPS 提升至 330.6 TFLOPS,均接近两倍。
不过实际收益要看具体工作负载。cuBLAS 矩阵运算测试中,FP16 提升约 12% 至 34%,BF16 部分测试提升 16% 至 20%,并非所有任务都能获得同等幅度的加速。
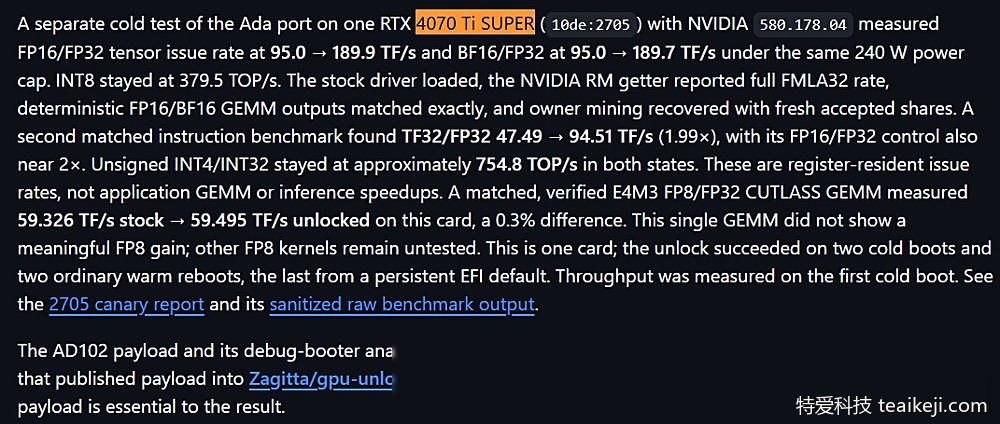
除 RTX 4090 外,开发者还在一张 RTX 4070 Ti SUPER 上完成了实验性验证,其 FP16、BF16 指令吞吐量同样接近翻倍。RTX 4060 Ti 16GB 也被列入实验性支持范围,但验证程度仍有限。
相关方案主要面向 Linux 环境,Windows 端有针对特定主板和显卡的独立实验移植,尚不具备普遍适用性。
对于本地 AI 生图和大模型应用而言,提示词处理、部分矩阵乘法等计算密集型环节有望受益。但实际生成速度还受显存带宽、模型量化方式及算子实现等因素限制,不能简单理解为出图速度或 Token 生成速度翻倍。
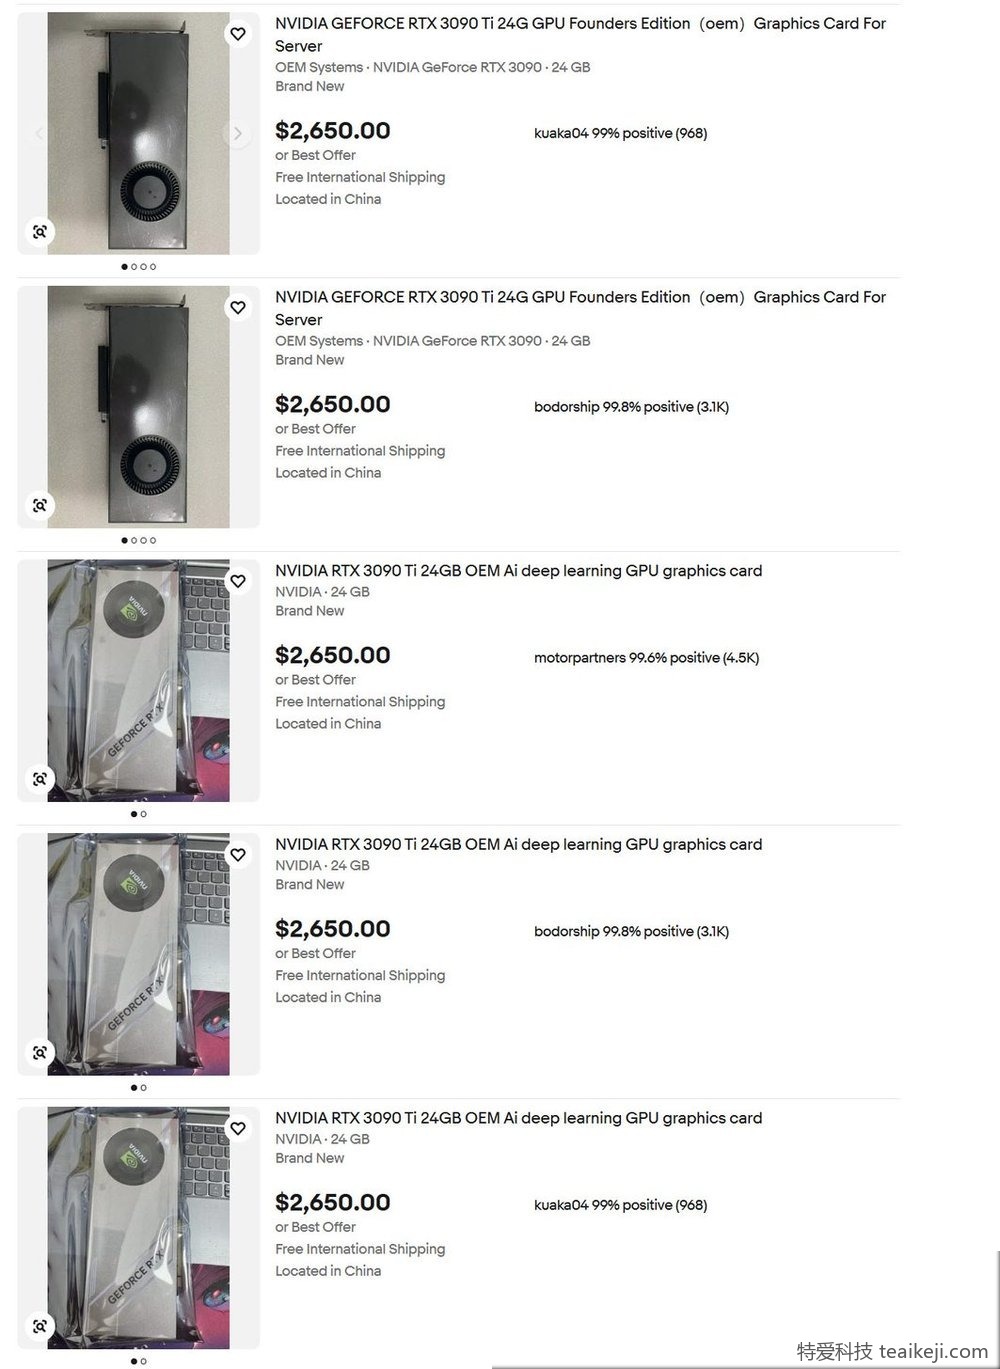
算力解锁也波及了老款显卡的二手市场。随着 RTX 30 系列在本地大模型推理和 AI 绘图中的价值被重新挖掘,WCCFTech 报道称:RTX 3090 24GB 此前约 1000 美元的二手价已突破 2000 美元,RTX 3090 Ti 更是飙涨到 2650 美元(约 17676 元人民币)。
对于原本打算买二手显卡的游戏玩家,这无疑是预算压力。换个角度看,手里有点闲钱的读者,是不是也可以考虑加入这场炒作?
资料来源:GitHub gpu-unlock-ada 项目、WCCFTech。
回复
举报
返回列表
发布新帖
高级模式
B
Color
Image
Link
Quote
Code
Smilies
您需要登录后才可以回帖
登录
|
立即注册
本版积分规则
发表回复
回帖后跳转到最后一页
浏览过的版块
社区
折腾
AI大模型
关于特爱科技
关于我们
加入我们
联系我们
内容与服务
AI大模型
AI硬件
AI交流
摄影
数码
扰辄
闲聊
帮助与支持
常见问题
投诉/建议
teaikeji@126.com
微信:teaikeji
Copyright © 2001-2026
特爱科技
版权所有
All Rights Reserved.
关灯
在本版发帖
扫一扫添加微信客服
返回顶部
快速回复
返回顶部
返回列表
首页
论坛
发布
消息
我的



 发表于 2026-10-26 15:33:45